Dunia digital bukan lagi wilayah baru bagi bahasa Hindi dan Inggris. Kecerdasan buatan dapat memproses pertanyaan, menghasilkan teks, dan mengenali bahasa lisan dalam kedua bahasa – juga karena tersedianya sejumlah besar data digital.
Namun, situasinya berbeda jika kecerdasan buatan tidak hanya mampu memahami bahasa Inggris atau Hindi yang digunakan secara luas, namun juga dapat digunakan dalam banyak bahasa lain di negara tersebut, yang seringkali lebih kecil, terutama jika tidak ada koneksi internet yang stabil.
India telah menetapkan tujuan untuk meningkatkan status mereka di dunia digital. Pada pertengahan September, inisiatif AI suara negara BHASHINI, bersama dengan mitranya, mempresentasikan kesimpulan dari kompetisi inovasi untuk apa yang disebut aplikasi edge AI. Ini tentang AI multibahasa yang dapat dijalankan secara langsung di perangkat. Aplikasi untuk pertanian, kesehatan, layanan sosial dan nasihat hukum juga disajikan.
Bahasa apa saja yang diperhitungkan?
Apa yang awalnya terdengar seperti pertanyaan teknis, kemudian menimbulkan pertanyaan yang lebih mendasar: Bahasa manakah di India yang benar-benar akan diperhitungkan dalam infrastruktur digital baru ini? Dan apa yang terjadi pada mereka yang datanya hampir tidak ada?
Penelitian menunjukkan seberapa besar masalahnya. Review terhadap 84 makalah penelitian yang diterbitkan pada tahun 2024 mengenai AI generatif dan model bahasa berukuran besar untuk bahasa-bahasa India menyebutkan kurangnya data, standarisasi, keragaman bahasa, dan pilihan evaluasi yang tidak memadai sebagai tantangan utama.
Insinyur kelistrikan dan pakar AI Julius Haas, yang tinggal dan bekerja sebagian di India, pertama-tama menunjukkan basis data yang tidak merata. Dibandingkan dengan bahasa Inggris atau Jerman, korpus teksnya jauh lebih kecil – “ini berlaku baik secara kuantitas maupun kualitas,” kata Haas dalam wawancara dengan Babelpos. Dialek lokal juga memberikan persyaratan khusus: perbedaan ejaan atau intonasi mungkin relevan.
Bahasa terkecil dan terancam punah
Untuk bahasa terkecil, batasannya bahkan lebih jelas. “Jika suatu bahasa sulit didokumentasikan dan hanya ada sedikit materi tertulis, maka tidak ada cukup data untuk melatih suatu model,” kata sosiolinguistik Ariba Hidayet Khan, yang mengajar di Universitas Kiel, dalam sebuah wawancara dengan Babelpos. Oleh karena itu, AI saat ini hanya dapat membantu bahasa-bahasa tersebut sampai batas tertentu.
Situasinya berbeda dengan bahasa-bahasa terancam punah yang masih digunakan dan setidaknya memiliki materi. Jika generasi muda semakin beralih ke bahasa yang lebih luas seperti Hindi atau Inggris, penawaran digital dapat menciptakan insentif untuk terus mempelajari bahasa mereka sendiri. “Jika kita menggunakan AI sekarang, hal ini dapat membantu melestarikan bahasa lebih lama,” kata Khan.
Contoh Turi juga menunjukkan batas harapan ini. Khan telah mengerjakan tata bahasa yang digunakan di beberapa bagian Jharkhand, Benggala Barat, dan Chhattisgarh, antara lain. Banyak pembicara berasal dari generasi tua. Jika dokumentasi dan pengeras suara hilang, AI pun tidak bisa begitu saja menghidupkan kembali bahasa tersebut.
“Pertanyaan tentang investasi”
Untuk itu, India berupaya membangun basis data yang diperlukan. Pemain kuncinya adalah AI4Bharat, sebuah lembaga penelitian di IIT Madras. Ini mengembangkan kumpulan data dan model untuk terjemahan, pengenalan ucapan, sintesis ucapan, dan model bahasa besar. Namun, data yang tersedia sangat berbeda dari satu bahasa ke bahasa lainnya.
“Pada dasarnya, ini adalah pertanyaan tentang investasi,” kata Julian Haas. “Terobosan teknologi yang mendasar tidak lagi diperlukan, meskipun perbaikan lebih lanjut, seperti tokenizer (catatan redaksi), tentu dapat membawa manfaat.” Yang penting adalah penggunaan dana penelitian dan sumber daya untuk pelatihan dan infrastruktur.
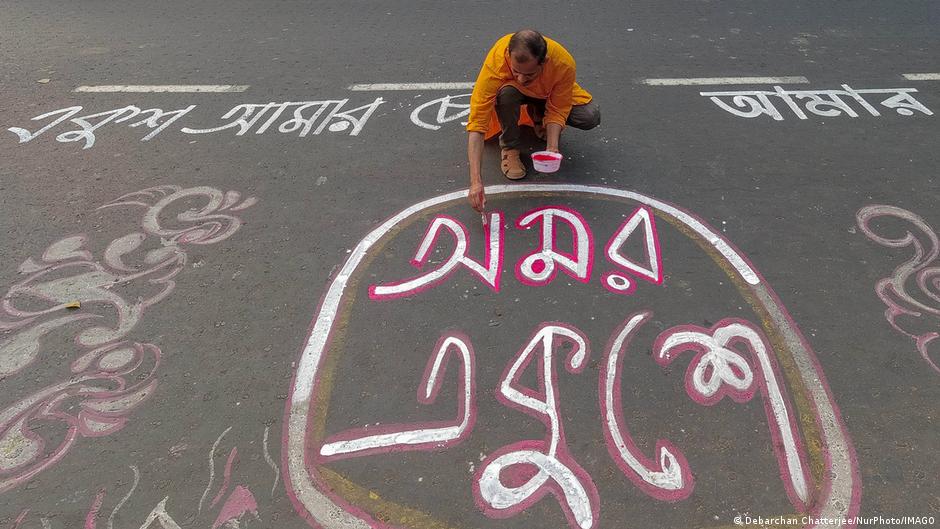
Bahasa berkaitan erat dengan pembelajaran, identitas, dan kepemilikan budaya, menurut Laporan Pendidikan India 2025dari UNESCO. Oleh karena itu UNESCO menyerukan teknologi digital inklusif yang mendukung pendidikan multibahasa. Keberagaman bahasa juga harus tercermin dalam ruang digital.
Hirarki baru tidak dapat dikesampingkan
Namun digitalisasi juga dapat menciptakan hierarki yang benar-benar baru. Karena AI tidak serta merta mewakili keseluruhan keragaman suatu bahasa. Jika data dari varian tertentu yang sudah ada tersedia untuk suatu model, hal ini dapat menjadi standar digital. Dalam hal ini, dialek-dialek dan bentuk-bentuk regional lain mungkin semakin kehilangan visibilitasnya.
“Kami sudah melihat bahwa AI bekerja lebih baik dengan bahasa Inggris Amerika, misalnya, dibandingkan dengan jenis bahasa Inggris tertentu lainnya,” kata Ariba Hidayet Khan. Hal ini menimbulkan bahaya khusus bagi India: “AI dapat memperkuat hierarki linguistik yang sudah ada.”
Tinjauan penelitian ini juga menunjukkan situasi sulit yang disebut bahasa dengan sumber daya rendah. Karena kurangnya data dalam jumlah besar, sedang dicari metode yang modelnya dapat mentransfer pengetahuan antar bahasa dan juga bekerja dengan sedikit materi. Mengembangkan AI untuk 22 bahasa tidak berarti semua bahasa tersebut sama-sama didukung oleh teknologi.
Hal ini menjadikan pengumpulan data sebagai bagian penting dari AI suara. Selain teks, bahasa lisan, dialek, dan varian daerah juga dicatat. Namun siapa pun yang mendigitalkan suatu bahasa juga mempunyai pilihan: misalnya, penutur dan ragam bahasa mana yang dicatat dan siapa yang boleh menggunakan data tersebut nanti.
Bagi Khan, partisipasi masing-masing komunitas bahasa sangatlah penting. “Komunitas yang menyediakan data ini harus mempunyai pendapat mengenai apa yang terjadi pada data tersebut.” Masyarakat tidak hanya harus menyediakan data, namun juga mempengaruhi kegunaan data tersebut. UNESCO juga menyerukan hal ini dalam “Peta Jalan Global untuk Multilingualisme di Era Digital” partisipasi yang lebih besar dari komunitas bahasa dalam pengelolaan data linguistik dan budaya.
Pedang bermata dua
Tantangan lainnya adalah infrastruktur teknis. Ketika model bahasa menjadi cukup kecil, model tersebut dapat dijalankan langsung di ponsel pintar atau perangkat lain. Hal ini mungkin penting bagi wilayah dengan koneksi internet yang lemah. “Secara teknis, penerapannya mudah,” kata Julius Haas. Penting untuk mengembangkan penelitian dan infrastruktur yang sesuai.
Hal ini menyisakan dua pertanyaan terbuka: Pertama, berapa banyak bahasa kecil yang benar-benar terlihat dalam sistem digital. Dan di sisi lain, siapa yang memutuskan versi bahasa mana yang menjadi standar digital. AI dapat mengaktifkan terjemahan, materi pembelajaran, dan akses baru terhadap informasi. Namun hal ini juga dapat mereproduksi atau bahkan memperkuat perbedaan-perbedaan yang ada. Keberagaman bahasa di ruang digital muncul tidak hanya melalui teknologi tepat guna – namun juga melalui keputusan mengenai data apa yang dikumpulkan dan siapa yang memilikinya.